Mostrando postagens com marcador apache cassandra. Mostrar todas as postagens

quarta-feira, 2 de outubro de 2013

Cassandra Trip Brasil [Agradecimentos]

O evento Cassandra aconteceu entre os dias 2 e 6 de setembro com o objetivo de falar dos conceitos de nosql, bigdata, do cassandra e da sua arquitetura além das novidades com a nova versão, o Cassandra 2.0. O evento foi um sucesso, com isso, gostaríamos de agradecer todos que participaram e ajudaram o evento de alguma forma.
Para saber mais sobre o Cassandra, trocar experiência e tirar dúvidas técnicas ou conceituais foi criado o grupo Cassandra Trip Brasil, para mais informações aqui.
Slides utilizados no evento:
http://www.slideshare.net/bcoverston/tutorial-session
http://www.slideshare.net/edwardribeiro/cassandra-tripbrasil
http://www.slideshare.net/otagonsan/cassandra-trip
Fotos da Trip: http://goo.gl/mFVDsl
Existirá uma próxima atividade para o Cassandra que é o um mini-curso gratuito de Cassandra. No dia 10 de outubro, quinta-feira, na Global Code.
Título: Primeiros passos com o Cassandra
Descrição: O Cassandra é um banco de dados NOSQL orientado à família de coluna que nasceu para resolver problemas com aplicações que precisam operar com gigantescas cargas de dados além de poder escalar com grande facilidade. Ele nasceu no facebook e hoje vem sendo usado intensamente por empresas dos mais variados portes, tais como Netflix, Twitter, Instagram, HP, IBM, dentre muitas outras. Um fator importante que vale ser citado é a sua adoção crescente inclusive em mercados mais conversadores tais como, instituições financeiras e agências governamentais como a NASA.
Público alvo: Desenvolvedores, DBAs,  entusiastas com curiosidade de conhecer mais sobre bancos de dados nosql e o banco Cassandra.
  Ementa:
  • Conceito Data Science
  • Conceito BigData
  • NOSQL
  • Histórico
  • Tipos de Bancos
  • Comparação com o Modelo relacional
  • Cassandra
  • Arquitetura Cassandra
  • Configurações Básica do Cassandra
  • Configuração de multi-nodes no Cassandra
  • Conhecendo o DevOpsCenter
  • Instalando os Agentes

Para aqueles que não são de São Paulo:
Link : https://globalcode.webex.com/globalcode/onstage/g.php?t=a&d=662489296
Pass: cassandra
Mais informações: http://goo.gl/S3LQBm

segunda-feira, 23 de janeiro de 2012

Persistindo com o Cassandra em java: exemplo simples


Os banco de Dados NOSQL (not only SQL) foram criados, principalmente, para resolver problemas com aplicações web que precisam operar com gigantescas cargas de dados além de poder escalar com grande facilidade. Esses tipos de banco de dados vem sendo usados com muita frequência em redes sociais como Twiter, Facebook, além de persistência em aplicações nas nuvens. O Cassandra é um tipo de banco nosql que originalmente foi criado pelo Facebook e que atualmente é mantido pela Apache e outras empresas. Ele é um sistema de banco de dados distribuído baseado no modelo BigTable do Google e no sistema de armazenamento Dynamo da Amazon.com.. Esse artigo tem como objetivo de realizar um passo a passo de um pequeno exemplo para persistir informações no Cassandra.
Para demonstrar um pouco do Cassandra será utilizado o Easy-Cassandra que é um framework open souce que visa está facilitando o uso desse banco nosql.


@ColumnFamilyValue(nome = "person")//
public class Person implements Serializable { 

private static final long serialVersionUID = 3L;

@KeyValue(auto=false)
private Long id;

@IndexValue//indica que esse campo eh um indece
@ColumnValue(nome = "name")//indica que serah uma coluna e o seu nome
private String name; 

@ColumnValue(nome = "year")
private Integer year;

@EnumeratedValue(nome="sex")//indica que esse campo serah um enum alem do nome do campo
private Sex sex;

@EmbeddedValue//indica que a classe Address estah embutida na classe Person
private Address address;
//getter and setter
}
listagem 1: Classe modelada com anotação para persistir a informação no Cassandra


public class PersonDAO {

private Persistence persistence;

public PersonDAO() {
persistence = EasyCassandraManager.getPersistence("javabahia", "localhost", 9160);
}

public void create(Person bean) {

   persistence.insert(bean);
}

public void remove(Person bean) {
   persistence.delete(bean);
}

public void remove(Long id){
    persistence.deleteByKeyValue(id, Person.class);
} 

public void update(Person bean) {

   persistence.update(bean);
}
public Person retrieve(Object id) {

   return (Person) persistence.findByKey(id, Person.class);
}
@SuppressWarnings("unchecked")
public List listAll() {

  return persistence.findAll(Person.class);
}

@SuppressWarnings("unchecked")
public List listByIndex(Object index) {
   return persistence.findByIndex(index, Person.class);
}
}
listagem 2: Classe que realiza a chamada para o banco de Dados


O código do pode ser baixado no link no final do artigo ao se observar a modelagem será visto as anotações a seguir:

  • ColumnFamilyValue anotação para indicar o nome da Família de Coluna,
  • ColumnValue indica os campos dentro da Família de Coluna,os formatos de campos disponíveis nessa versão são:
  • java.lang.Boolean
  • java.util.Date
  • java.lang.Double
  • java.lang.Float
  • java.lang.Integer
  • java.lang.Long
  • java.lang.String
KeyValue: Indica que esse campo será a chave da família de consulta, existe a opção de auto_increment que vem desabilitada por padrão.
  • IndexValue: indica que esse campo é um índice, assim como a chave com ele você pode buscar informações a partir desse campo o máximo de indice criado é um, mas mesmo criando apenas um índice existe um perda de performance considerável ou seja faça o máximo possível para não se ter índice.
  • EnumeratedValue: indica que esse campo é do tipo Enum
  • EmbeddedValue: essa anotação indica que existe mais campos dentro dele, a persistência continuará na forma de uma grande tabela, mas esse campo é util para modelar a informação em mais objetos.

As anotações ColumnFamilyValue, ColumnValue e EnumeratedValue caso o campo “name” não seja preenchido o padrão é o nome da classe ou nome da variável.

Tão logo o código tenha sido observado vamos colocar o código para rodar. Os requisitos para o código funcione são os seguintes:

  • JDK 7 ou acima
  • O cassandra esteja rodando
  • Criar o Keyspace e Family column
  • Realizar a anotação na classe
  • Realizar a chamada para salvar objeto
  • Adicionar a Lib do Cassandra
  • Adicionar as dependências do Thrift
Para rodar o pequeno exemplo siga os seguintes passos:

  • Baixe o apache cassandra aqui
  • Descompacte o arquivo e entre no arquivo descompactado
  • Ao entrar na pasta inicie o Cassandra com o seguinte comando:
./bin/cassandra -f
  • Em seguida use no modo cliente para isso com outro terminal entre na pasta recém descompactada e execute o seguinte comando:
./bin/cassandra-cli -host localhost

  • No modo cliente para criar um keyspace e família de coluna execute:

create keyspace javabahia;
use javabahia;
create column family person with
comparator = UTF8Type and
column_metadata =
[
  {column_name: name, validation_class: UTF8Type, index_type: KEYS}
];

  • Realize o download do projeto
  • Realize o download das libs e adicione elas no classpath no projeto
  • Pronto agora seu primeiro exemplo com o Cassandra funciona.
Esse artigo teve como objetivo a mostrar um pequeno exemplo persistindo informações no Cassandra para isso foi utilizado o Easy-Cassanda. O exemplo está disponíveis tanto para o netbeans tanto para o Eclipse.


Download do código e das Libs:


Wiki Easy-Cassandra:


home Easy-Cassandra:


Mais sobre nosql e Cassandra:


sábado, 10 de dezembro de 2011

Desenvolvendo com NOSQL -Cassandra em java – parte 3 Conhecendo Cassandra


Desenvolvendo com NOSQL -Cassandra em java – parte 3 Conhecendo Cassandra

     No primeiro e segundo artigo foi introduzido com o conceito de banco de dados NOSQL suas semelhanças com o banco relacional além de sua classificação na terceira parte finalmente será falado sobre o Cassandra . O cassandra é um banco de dados nosql de arquitetura distribuída, seu armazenamento é configurável (híbrido) e usa o modelo de família de colunas, o seu projeto foi inciado pela equipe do facebook e atualmente é mantido pelo apache, foi desenvolvido na plataforma java. Seu principal case de sucesso é o twitter, facebook e o Digg. Possui api para as linguagens Ruby, Perl, Scala, Python, PHP e Java.
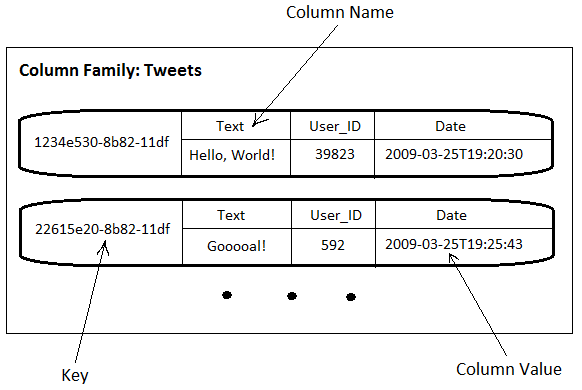
Como o cassandra usa o modelo família de colunas, ele é composto por keysotre, supercoluna e coluna. 


   Os tipos de valores que possam ser ineridos nas colunas são:


  •     BytesType: tipo simples pelo valor de byte. Nenhuma validação é executada. 
  • AsciiType: Como BytesType, mas confirma que a entrada pode ser analisado como US-ASCII.
  •     UTF8Type: Uma string codificada como UTF8
  •     LongType: Um longo 64bit
  •     LexicalUUIDType: Um UUID de 128 bits, em comparação léxica (por valor byte)
  •     TimeUUIDType: a versão 1 UUID de 128 bits, comparados por timestamp


Nível de Consistência do Casssandra

    Para garantir tolerância a falhas, os dados no Cassandra precisam ser replicados. O campo timestamp funciona como uma bússola verificando o campo mais atual entre as replicas. De uma maneira geral o comportamento de leitura e escrita no cassandra pode ser definida por apenas três itens:

ONE (1) - Na escrita, garante que o dado foi escrito em um commit log e uma tabela de memória de ao menos uma réplica antes de responder ao cliente. Na leitura, o dado será retornado a partir do primeiro nó onde a chave buscada foi encontrada. Essa prática pode resultar em dados antigos sendo retornados, porém, como cada leitura gera uma verificação de consistência em background, consultas subsequentes retornarão o valor correto do dado;

QUORUM (Q) - Na escrita garante que o dado foi escrito em N/2+1 réplicas. Na escrita retorna o valor mais recente lido de N/2+1 réplicas. As réplicas restantes são sincronizadas em background;

ALL (N) - Garante que operações de leitura e escrita envolverão todas as réplicas. Assim, qualquer nó que não responda às consultas fará as operações falharem. 


A tabela 1 e 2 demonstra os níveis de consistência de escrita e leitura respectivamente.


ESCREVER
Nível
Comportamento
ANY
Garantir que a gravação foi escrito para pelo menos 1 nó, incluindo destinatários .
ONE
Garantir que a gravação foi escrita a pelo menos 1 log réplica cometer e tabela de memória antes de responder ao cliente.
QUORUM
Garantir que a gravação foi escrito para N / 2 + 1 réplicas antes de responder ao cliente
LOCAL_QUORUM
Garantir que a gravação foi escrito para / 2 + 1 nós, dentro do datacenter local (requer NetworkTopologyStrategy)
EACH_QUORUM
Garantir que a gravação foi escrito para / 2 + 1 nós em cada datacenter (requer NetworkTopologyStrategy)
ALL
Garantir que a escrita é escrita para todas as réplicas N antes de responder ao cliente. Quaisquer réplicas responder irá falhar a operação.


Ler
Nível
Comportamento
ANY
Não suportado. Você provavelmente vai querer uma vez.
ONE
Retornará o registro retornado pela primeira réplica para responder. A verificação de consistência é sempre feito em um thread em segundo plano para corrigir os problemas de consistência quando ConsistencyLevel.ONE é usado. Isto significa chamadas subsequentes terão dados corretos mesmo que a leitura inicial é um antigo valor. (Isso é chamado ReadRepair)
QUORUM
Irá consultar todas as réplicas e retornar o registro com o timestamp mais recente, desde que tenha pelo menos a maioria de réplicas (N / 2 + 1) relatados. Novamente, as réplicas restantes serão verificadas em segundo plano.
LOCAL_QUORUM
Retorna o registro com o timestamp mais recente, desde a maioria das réplicas dentro do datacenter locais têm respondido.
EACH_QUORUM
Retorna o registro com o timestamp mais recente, desde a maioria das réplicas dentro de cada datacenter ter respondido.
ALL
Irá consultar todas as réplicas e retornar o registro com o timestamp mais recente, uma vez todas as réplicas ter respondido. Quaisquer réplicas responder irá falhar a operação.


    Apresentado um pouco sobre o cassandra iniciaremos o processo de instalação e configuração dele, para iniciar baixe-o no site do projeto (http://cassandra.apache.org/). Em seguida basta descompactar e dar o seguinte comando dentro da pasta que foi descompactada:

bin/cassandra -f


Para executar o cliente dentro da pasta descompacta execute o seguinte comando:

bin/cassandra-cli -host localhost


Conclusão:

       No próximo artigo da série será mostrado um exemplo de implementação utilizando o cassandra nosql, como citado antes para acessar tais recursos é utilizado uma api específica que varia por linguagem além de varia por tipos de nosql, no nosso caso será focado a linguagem java no Cassandra.

Referências:


Java Magazine nº 86 Introdução ao nosql

http://escalabilidade.com/2010/03/08/introducao-ao-nosql-parte-i/