Mostrando postagens com marcador bancos nosqls. Mostrar todas as postagens

sábado, 11 de agosto de 2012

Cassandra + Lucene


         Atualmente existem diversas características dos bancos NOSQL, em diferentes arquiteturas, formas de armazenamento de informação e estruturas de dados. No entanto apesar dessa grande variedade no número e variedades eles compartilham uma coisa em comum. Eles normalmente buscam pela chave primária. Apesar de conseguir-se manter altamente disponível, inserir e recuperar informações de forma bastante rápida, o fato de que a maioria dos bancos NOSQL somente recuperem pela chave, torna um pouco difícil adaptar a aplicação para o seu uso, já que nem sempre você consegue buscar apenas pela chave no banco. Para não abrir mão da alta disponibilidade e recuperar informações não apenas em chave, uma boa opção certamente é “terceirizar” esse serviço. Por esse motivo será apresentado o Lucene trabalhando em conjunto com um banco nosql, mais precisamente o Cassandra, juntando o bom de dois mundos em sua aplicação.
O Apache Lucene é uma API de busca e indexação de documentos, escrito em Java. Ele é composto por basicamente duas etapas: indexação e pesquisa. Dado o texto primeiro passo é a indexação que processa os dados originais e gera uma estrutura que facilita a busca e gera palavras-chaves, em seguida vem à busca que visa estar buscando a partir das palavras-chaves indexadas e retorna pela semelhança do texto com a consulta. A vantagem é que o Lucene abstrai ao ponto que não é necessário que o desenvolvedor saiba algoritmo de indexação. Os índices podem ser criados em ambientes distribuídos, aumentando o desempenho e a escalabilidade da ferramenta.
Apresentado um pouco da ferramenta o objetivo agora será apresentar uma prática envolvendo os dois mundos: banco nosql e o Lucene. Para essa parte prática será feita uma aplicação com o objetivo de estar cadastrando currículos. A idéia é bastante simples:


  1. O usuário estará cadastrando o currículo com suas informações.
  2. A partir dessas informações a analista de recursos humanos estará buscando o profissional.
  3. O profissional poderá ser buscado pela palavra chave de uma qualificação técnica, localização, Profissão.
Como o objetivo da aplicação será web, estaremos utilizando a plataforma Java EE em sua versão mais recente, a versão 6.0.
      No Lucene os índices são armazenados a partir da interface Direcoty que no momento que eu escrevo possui basicamente duas implementações: Uma para armazenar na memória RAM e para armazenar no disco rígido. Como o objetivo é garantir uma alta disponibilidade estaremos utilizando a opção de estar trabalhando com os índices na memória RAM, mas para não perdemos tais índices estaremos fazendo um backup no disco rígido. Para fazer tal procedimento, usaremos o recurso schedule do EJB 3.1 para de tempos em temos, jogar o que está na memória para o HD.

@Schedule(minute = "*/1", hour = "*")
  public void reindex() {
   
    try {   
      Directory disco = FSDirectory.open(new File(Constantes.getIndexDirectory()));
      luceneManager.backup(directory, disco);
      
    }
    catch (Exception e) {
     Logger.getLogger(ScheduleService.class.getName()).log(Level.SEVERE,
                null, e);
    }

  }


    Desse modo quando a aplicação cair e levantar novamente basta estar carregando as informações do disco para a memória principal novamente. Vale salientar que o diretório precisar único para toda a aplicação.

 
@ApplicationScoped
public class LuceneManager implements Serializable{

 private static final long serialVersionUID = -8280220793266559394L;
 
  @Produces
        private Directory directory;
    

    @Inject
    public void init() {
        directory = new RAMDirectory();
        try {
            levantarServico();
        } catch (IOException e) {
         Logger.getLogger(LuceneManager.class.getName()).log(Level.SEVERE,
                    null, e);
        }
    }

    public void levantarServico() throws IOException {
        Directory disco = FSDirectory.open(new File(Constantes.getIndexDirectory()));
        backup(disco, directory);
    }

    public void backup(Directory deDiretorio, Directory paraDiretoria) throws IOException {

        for (String file : deDiretorio.listAll()) {
            deDiretorio.copy(paraDiretoria, file, file); // newFile can be either file, or a new name
        }
    }

}

  
    Uma vez criado o diretório e definido onde estarão as informações o próximo passo é criar os índices, conforme falado anteriormente ele será a chave tanto para a inserção quando a busca das informações. Agora o que falta é a criação do Document que representa para a troca de informações entre o Lucene e sua aplicação. Ele é composto por campos que por sua vez por informações. A relação entre o Lucene e a aplicação se dará da seguinte forma:
  • A chave será armazenada e não indexada.
  • O estado não armazenado e não indexado.
  • O conteúdo do currículo será não armazenado e indexado.


  private Document criarDocumento(Pessoa pessoa) throws IOException {
    Document document = new Document();

    document.add(new Field(Constantes.ESTADO_INDICE,pessoa.getEndereco().getEstado(), Store.YES,
        Index.NOT_ANALYZED_NO_NORMS));
    document.add(new Field(Constantes.ID_INDICE,pessoa.getNickName(), Store.YES,
            Index.NOT_ANALYZED_NO_NORMS,TermVector.WITH_POSITIONS_OFFSETS));

    document.add(new Field(Constantes.TUDO, getConteudoCurriculo(pessoa), Store.NO,
        Index.ANALYZED));

    return document;
  }

Uma vez essa informação armazenada no Cassandra e indexada no Lucene, o ciclo da aplicação se dará da seguinte forma:
  • A seqüência segue um processo simples:
  • O usuário adiciona as informações e envia ao servidor
  • A informação é persistida no Cassandra
  • A informação é indexada e é armazenado o id no Lucene
  • Quando o analista de RH fizer a busca é recuperado um Document que por sua vez retorna a informação da chave, assim poderá se recuperada todas as informações no Cassandra.


         Pronto! Dessa forma quanto a inserção quanto a busca serão feitas de maneiras rápidas, o Cassandra possui o recurso de índices secundários que permite que existam campos de busca além da chave, mas isso faz com que o banco perca velocidade com o crescimento desses campos especiais. Uma outra forma de deixar a busca ainda mais rápida seria deixar os resultados dessa busca em um cachê, mas isso serão cenas para um próximo capítulo.
Falando um pouco mais sobre o Lucene existem alguns frameworks que já se integram com o Lucene. É o caso do hibernate search que é o hiberante, para banco relacional, utilizando o Lucene, solr é um servidor de busca que usa o Lucene como motor de busca e o solandra que é um solr para o Cassandra.
Nesse artigo foi apresentado um problema existente na maioria dos bancos NOSQL, a busca de campos além da chave. Para resolver tal problema foi demonstrado um trabalho em conjunto com o Lucene, ferramenta de indexação de documentos, além de apresentar alguns conceitos da ferramenta.


Referências: 
Conhecendo o Lucene, PAULO SIGRIST e WILSON AKIO HIGASHINO, java Magazine 104, devmedia.

Código Fonte: http://softwarelivre.org/otagonsan/codigofonte/cassandra-lucene.rar


segunda-feira, 16 de abril de 2012

Lançada a versão 1.0.9 beta do apache Easy-Cassandra.


   Lançada a mais nova versão do framework que visa facilitar a persistência de objetos do apache Cassandra. Dentre as suas novidades está nas anotações, nessa versão estará usando as anotações do JPA. Outra novidade é o uso do recurso de JPQL, com isso se pode realizar querys com objetos e a ferramenta se encarregará de fazer a tradução para o Cassandra, para isso se utiliza a interface JCassandra que estende de javax.persistence.Query. A expectativa é que aumentar ainda mais a produtividade para o desenvolvimento.
JCassandra jCassandra=persistence.createJCassandra("select * from Person");
 List<Person> persons=jCassandra.getResultList();

tabela 1: exemplo usando o jpql no Easy-Cassandra


Conforme dito acima as anotações foram adaptadas conforme mostra a tabela 2.

Easy-Cassandra 1.0.8
Easy-Cassandra 1.0.9 (Com JPA anotação)
org.easycassandra.annotations.ColumnFamilyValue
javax.persistence.Entity
org.easycassandra.annotations.ColumnValue
javax.persistence.Column
org.easycassandra.annotations.EmbeddedValue
javax.persistence.Embedded
org.easycassandra.annotations.EnumeratedValue
javax.persistence.Enumerated
org.easycassandra.annotations.KeyValue
javax.persistence.Id
org.easycassandra.annotations.KeyValue equals true
javax.persistence.GeneratedValue
org.easycassandra.annotations.IndexValue
org.easycassandra.annotations.Index
tabela 2: relação entre as anotações da versão 1.0.8 e 1.0.9 com anotação jpa.


   Também foi adicionado funcionalidade na anotação @Version do jpa, seu objetivo é verificar o tempo de inserção ou modificação do objeto.
@Entity(name = "autocount")
public class Count implements Serializable {

    private static final long serialVersionUID = 3L;
    
    @Id
    @GeneratedValue
    private BigInteger id;
    
  
    @Column(name = "name")
    private String name;
    
    @Version
    private Long timeStampLong;

    @Version
    private Date timeStampDate;
    
    @Version
    private Calendar timeStampCalendar;

//getter and setter
}

tabela 3: Usando a anotação version


   Para demonstrar novos recursos do framework será feito um exemplo de álbuns musicais que possa ser chamados em várias plataformas, para isso será usado web services. Para realizar esse exemplo será utilizado o java EE 6. Como o foco desse artigo não será o java EE 6, não entraremos em detalhes do mesmo. Após modelar e realizar as anotações com o jpa nossa classe ficará como mostra a tabela4.

@XmlRootElement
@Entity
public class Album implements Serializable{
@Id
private Long id;
@Column(name="nameOfAlbum")
private String name;
@Column
private String style;
@Column
private Calendar release;
@Column
private Double price;
@Embedded
private Artist artist;
//getter and setter
}
@XmlRootElement
public class Artist implements Serializable{
/**
* name of the artist
*/
@Column(name="nameOfArtist")
private String name;
/**
* was born
*/
@Column
private String country;
@Enumerated
private Sex sex;
//getter and setter
}

@XmlRootElement
public enum Sex {
MALE,FAMALE
}
tabela 4: classe com anotações jpa para o Easy-Cassandra


   Uma vez pronta a classe de anotação o que será feito agora é recurso para o rest, uma coisa que vale salientar é que a inteface JCassandra estende da interface javax.persistence.Query, assim se pode estar a utilizando a interface Query (interessante para quem já está acostumado com o uso do jpa). Sendo que nem todas os métodos dessa interface estão implementados.

Assim realizando as chamadas com o novo recurso de jpql no Cassandra ficará de acordo mostra a tabela 5. Vale salientar como é feito para o Easy-Cassandra gerenciar a classe. Esse processo é realizado sem a necessidade do uso do xml, para isso é usado do método addFamilyObjec na Classe EasyCassandraManager. É necessário que a classe seja adicionada antes de se criar um jpql da respectiva classe. No nosso exemplo ele será feito na classe PersistenceManagement tão logo uma conexão para o cassandra for criada, como mostra a tabela 5.


@ApplicationScoped
public class PersistenceManagement {
@Produces
private Persistence persistence;
@Inject
public void init(){
persistence=EasyCassandraManager.getPersistence("javabahia", "localhost", 9160);
EasyCassandraManager.addFamilyObject(Album.class);
}
}

@RequestScoped
public class PersistenceService {

@Inject    
 private Persistence persistence;
   
    public List<Album> findAllAlbum() {
        Query query=persistence.createJCassandra(" select * from Album");
        return query.getResultList();
    }

    public Album findById(Long id) {
        Query query=persistence.createJCassandra(" select * from Album where id =:id");
        query.setParameter("id", id);
        return (Album) query.getSingleResult();
        
    }

    public boolean save(Album album) {
      return  persistence.insert(album);
    }

    public void remove(Long id) {
        persistence.deleteByKeyValue(id, Album.class);
    }

    public String update(Long id, String name, String style, Double price,String nameOfArtis,String country) {
       StringBuilder query=new StringBuilder();
     
       
        boolean updatable=createMethod(query, name, style, price, country, nameOfArtis);
     
       if(!updatable){
            return "nothing is update";
       }
       
       Query jCassandra=persistence.createJCassandra(query.toString());
       setParameter(name, jCassandra, style, price, nameOfArtis, country);   
       jCassandra.setParameter("id", id);
       return jCassandra.executeUpdate()==1?"executed with sucess":" error in update ";
     
    }

    private void setParameter(String name, Query jCassandra, String style, Double price, String nameOfArtis, String country) {
        if(!isnull(name)){
        jCassandra.setParameter("name", name);
     }
     if(!isnull(style)){
  
      jCassandra.setParameter("style", style);
     }
     if(!isnull(price)){
       jCassandra.setParameter("price", price);
     }
     if(!isnull(nameOfArtis)){
    
      jCassandra.setParameter("artist", nameOfArtis);
     }
     if(!isnull(country)){
       jCassandra.setParameter("country", country);
     }
    }

    private boolean createMethod(StringBuilder query, String name, String style, Double price, String country, String nameOfArtis) {
        String conecion="";
        boolean updatable=false;
        query.append("update Album set ");
        if(!isnull(name)){
            query.append(conecion);
            query.append(" name =:name ");
            updatable=true;
            conecion=" , ";
        }
        if(!isnull(style)){
        query.append(conecion);
            query.append(" style =:style ");
            updatable=true;
            conecion=" , ";
        }
        if(!isnull(price)){
            query.append(conecion);
            query.append(" price =:price ");
            updatable=true;
        }
        
          if(!isnull(country)){
        query.append(conecion);
            query.append(" artist.country =:country ");
            updatable=true;
            conecion=" , ";
        }
        if(!isnull(nameOfArtis)){
            query.append(conecion);
            query.append(" artist.name =:artist ");
            updatable=true;
        }
        
        query.append(" where id =:id ");
        return updatable;
    }


    private boolean isnull(Object object){
    
        return object==null;
    }
    
}


tabela 5: realizando um jpql no cassandra


Uma vez implementados as querys será feito agora as chamadas agora será criado o recurso conforme mostra a tabela 6.

@Path("/album")
@RequestScoped
public class AlbumResource {
@Inject
private PersistenceService persistenceService;

@GET
@Produces(MediaType.TEXT_XML)
public List getProdutos() {
return persistenceService.findAllAlbum();
}
@Path("{id}")
@GET
@javax.ws.rs.Produces(MediaType.TEXT_XML)
public Album getAlbum(@PathParam("id") long id) {
return persistenceService.findById(id);
}

@Path("update/{id}")
@GET
@javax.ws.rs.Produces(MediaType.TEXT_PLAIN)
public String updateAlbum(@PathParam("id") Long id ,@QueryParam("name") String name,@QueryParam("style") String style,@QueryParam("price") Double price,@QueryParam("artist") String nameOfArtis,@QueryParam("country") String country) {

return persistenceService.update(id,name,style,price,nameOfArtis,country);
}
@POST
@Consumes(MediaType.TEXT_XML)
@Produces(MediaType.TEXT_PLAIN)
public String addAlbum(Album album) {
boolean sucess=persistenceService.save(album);
if(sucess){
return album.getName() + " added!";
}
return album.getName() + " not added!";
}


@Path("{id}")
@DELETE
@Produces(MediaType.TEXT_PLAIN)
public String removeAlbum(@PathParam("id") Long id) {
persistenceService.remove(id);
return "Album removed.";
}
}
tabela 6: criando um servidor  rest com o JAX-RS


   Uma das maneiras de se realizar os testes é utilizando o poster, um plugin para o firefox, que estará disponível nos links. Com ele se poderá realizar todos os testes, inclusive aqueles que envolvam o post e remove. É possível realizar alguns testes já no navegador:

Lista de álbum
Lista o álbum com o id 1
Lista o álbum com o id N
Insere ou atualiza um álbum com id igual a 12 com o nome, país Brasil, estilo eletrônico, preço 23 e o artista eu
tabela 7: exemplos de serviços com o rest


   Com isso foi demonstrado as novidades da nova versão do Easy-Cassandra, versão 1.0.9, que visa facilitar a vida do desenvolvedor. Foi demonstrado as mudanças para anotações típicas do jpa, novo recurso que recupera o timestamp da linha além do uso do JPQL por parte do framework. Muito ainda se tem de melhorar na ferramenta, mas com ajuda da comunidade isso será possível.


Link:
Exemplo servidor rest (AlbumServerRest.rar): https://github.com/otaviojava/Easy-Cassandra/downloads

Download o código e a documentação para a versão 1.0.9 ( documento 03): https://github.com/otaviojava/Easy-Cassandra/downloads


domingo, 20 de novembro de 2011

Desenvolvendo com NOSQL - Cassandra em java –Classificação de bancos NOSQL


     No artigo anterior foi mostrado um conceito básico sobre os banco nosql além de fazer comparações entre os bancos“tradicionais” com os bancos nosql. Nesse artigo será abordado sobre os tipos de bancos nosql além de sua classificação serão mostrados também alguns exemplos. Esses bancos por serem bastante novos ainda não existem padrões, ou seja, por mais que dois bancos possuam exatamente as mesma classificações não é absoluto afirmar que eles possuem os mesmo recursos e que fazem as mesmas coisas sem falar no grande trabalho que haverá na mudança de um banco nosql para o outro mesmo sendo semelhantes.  Existem hoje diversos SGBDs que se encaixam como nosql eles são classificados por: Arquitetura,  Armazenamento, modelo dedados:


Arquitetura
          Na arquitetura se pode dividir em dois tipos: distribuídos e não distribuídos.  Os distribuídos tomam a responsabilidade pela partição dos dados e pela sua replicação.

Distribuídos:
·     AmazonDynamo
·     Scalaris
·     Voldemort
·     CouchDb
·     Riak
·     MongoDb
·     BigTable
·     Cassandra
·     HyperTable
·   HBase
Não distribuídos:
·     Redis
·     TokyoTyrant
·     MemcacheDb
·   AmazonSimpleDb 


Armazenamento:
          Se defini por aqueles que  armazenam dados em disco e os que armazenam na memória.  Esta diferenciação é importante por que no caso da gravação em disco você vai precisar de um cache explicito.  Já os dados armazenados em memória não são duráveis. Um ponto interessante a ser avaliado é que no disco os dados tem menos possibilidade de ser perdidos no entanto o custo de I/O é altíssimo já com memória apesar de ser mais rápido o acesso deve-se levar em conta o fato dos dados ficarem em regiões voláteis.
Memória:
·     Scalaris
·   Redis
Disco:
·     CouchDb
·     MongoDb
·     Riak
·   Voldemort
Configurável
·     BigTable
·     Cassandra
·     Hbase
·   HyperTable 


Modelo de dados
No modelo de dados é definido como a informação é armazenada e estruturada dentro do banco.
·     Chave/Valor Possuiuma estrutura muito semelhante a do java.util.Map, onde podemos armazenar uma chave e seu valor. Esse valor pode ser qualquer informação.
·     AmazonDynamo
·     AmazonS3
·     Redis
·     Scalaris
·   Voldemort 


Documento
Estemodelo permite armazenar qualquer documento, sem ter a necessidade de definir previamente sua estrutura. O documento e composto por uma inúmeros campos, com tipos de dados diversos, inclusive um campo pode conter um outro, possui uma estrutura  semelhante a um  arquivo XML.
·     AmazonSimpleDb
·     ApacheCouchdb
·     MongoDb
·   Riak 


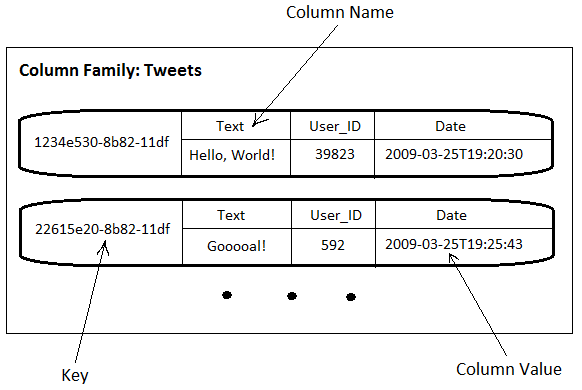
Colunas  Essemodelo se tornou  popular através do paper BigTable do Google, com o objetivo de montar um sistema de armazenamento de dados distribuído, projetado para ter um alto grau de escalabilidade e de volume de dados é composto por três componentes
          Keyspace tem como função agrupar um conjunto de Famílias de Colunas. Semelhante a um banco de dados relacional.
          Família de Colunas  organizas as colunas. faz o uso de uma chave única, que traz flexibilidade ao modelo sem poluir as linhas com colunas nulas. Semelhante a uma tabela no modelo relacional.
          Coluna, que é uma tupla composta por nome,timestamp e valor, onde os dados são realmente armazenados.
  Duas características adicionais e importantes deste modelo são a forma de consulta, que pode ser executada apenas através da chave das linhas de uma família de colunas, e a necessidade de definir previamente o conjunto de colunas que podem ser armazenadas em cada família.
·     Cassandra
·     GoogleBigTable
·     HBase
·      Hyperbase 

 Grafo(whiteboardfriendly) é uma estrutura de dados que conecta um conjunto de vértices através de um conjunto de arestas. Os bancos de dados de grafo modernos suportam estruturas de grafo multi-relacionais, onde existem tipos diferentes devértices (representando pessoas, lugares, itens) e diferentes tipos de arestas(como por exemplo amigo de, mora em, comprado por.
·     Neo4j
·     InfoGrid
·     Sones
·    HyperGraphDB


 Conclusão:
Neste artigo foi falado sobre os diversos tipos de bancos NOSQL, além de classificá-los por arquitetura, armazenamento e modelo dados. Com isso conclui-se que com o grande número de aplicações e suas diversidade se fez necessário a criação de algumas forma de armazenamento para atender melhor um requisito específico. Finalizado uma breve introdução sobre o NOSQL no próximo artigo será falado sobre o Cassandra e suas características.

 
 Referência:
Porcelli,Alexandre. Java Magazine nº 86 Introdução ao nosql
http://escalabilidade.com/2010/03/08/introducao-ao-nosql-parte-i/
Valéria Quadros dos Reis  http://horasdeocionerd.blogspot.com/2011/02/consistencia-dos-dados-no-cassandra.html